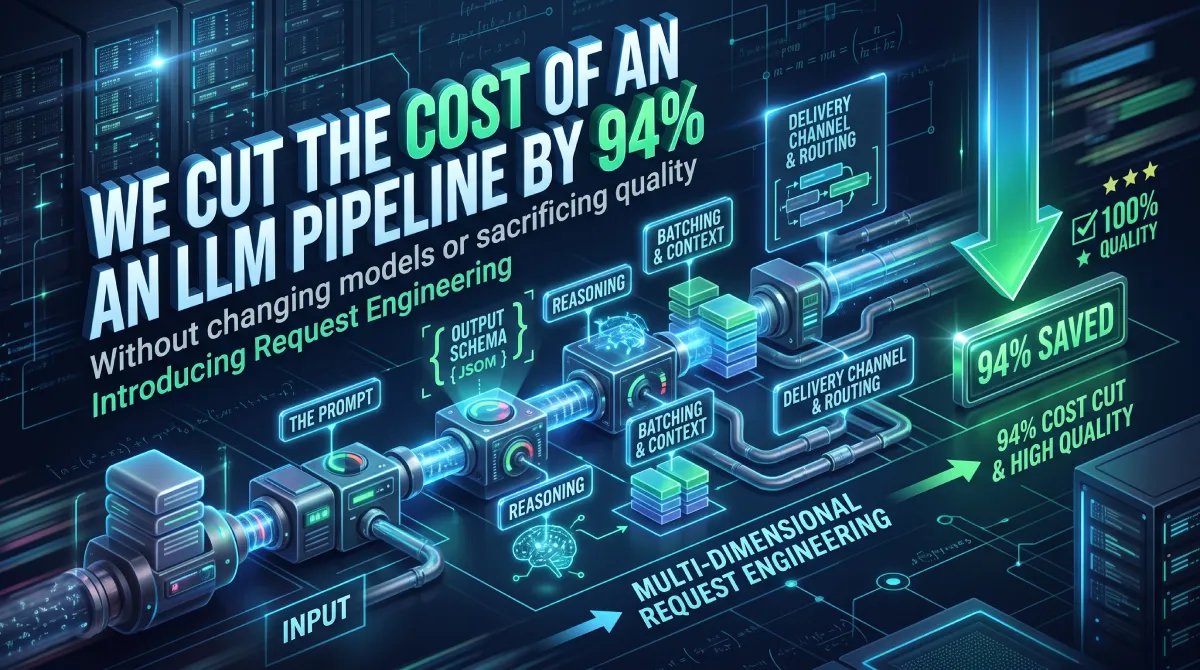
En un trabajo reciente recortamos un 94% el coste de un pipeline con LLM sin cambiar de modelo ni tocar la calidad. El ahorro no vino de reescribir el prompt, sino de cómo hacíamos la llamada. Qué enviábamos, qué pedíamos de vuelta, cuántas veces y por qué vía.
El estándar de la industria a esto le llama "Inference Engineering", pero a mi me gusta y creo que es más apropiado llamarlo request engineering: diseñar la petición completa, no solo el texto del prompt. El prompt es solo una de las partes de una petición a la IA, y se le suele dar demasiada importancia dado el nivel de los modelos frontier actuales. El esquema de salida, el razonamiento, el modelo, el tamaño del contexto, la agrupación y el canal de envío pueden tener muchísimo más peso para resolver correctamente la tarea y optimizar el coste por petición.
En este artículo os voy a explicar cómo usar cada una, con un caso real anonimizado y sus números. Optimizamos las peticiones haciendo un trabajo de request y context engineering, reduciendo tanto el volumen de llamadas como el coste de las mismas.
1. Gastamos mucho más de lo previsto
El caso: un proceso periódico que recibe reseñas de producto y hace dos tareas con un modelo pequeño (Claude Haiku 5.5):
- Extracción. Por cada reseña, el modelo devuelve el producto principal, hasta cinco entidades secundarias y una categoría de una lista cerrada.
- Desambiguación. Las entidades que no están en nuestra base de datos se buscan en un catálogo externo. El catálogo devuelve varios candidatos y el modelo elige el correcto.
El presupuesto se hizo así: N reseñas × 1 llamada × unos cientos de tokens. Pero la factura real resultó ser muchas veces mayor.
El error de fondo (bastante habitual): se presupuestan llamadas, pero se pagan tokens. Y no todos los tokens cuestan lo mismo, ni se ven en la respuesta.
2. Anatomía de una llamada: dónde se van los tokens
Una llamada a la API no es "el prompt". Esto es todo lo que se paga entero en cada petición:
| Parte | Qué es | ¿Se repite en cada llamada? | Precio |
|---|---|---|---|
system | Instrucciones fijas | Sí | Input |
tools / esquema | Definición de la salida estructurada | Sí | Input |
| Mensaje de usuario | El dato a procesar + contexto | Cambia | Input |
| Razonamiento (thinking) | Lo que el modelo piensa antes de responder | Cambia | Output |
| Respuesta | Lo que ves | Cambia | Output |
Hay dos ideas que hay que tener claras para adaptar todo lo demás:
- Lo fijo se paga en cada llamada. Unos cientos de tokens de instrucciones y esquema son poca cosa una vez, pero es mucho al multiplicarse por miles de llamadas.
- El output es caro. En Haiku 5.5 cuesta $0,50 por millón frente a $0,10 del input: cinco veces más. Y una parte del output, el razonamiento, no aparece en la respuesta que lees.
3. El prompt: claridad antes que longitud
El trabajo en producción es muy diferente de hacer peticiones en un chat. Un buen prompt para producción es corto, estable y sin duplicados. Tres reglas:
Instrucciones fijas en system, datos en el mensaje de usuario. En el código original, las reglas de categorización iban dentro del mensaje de usuario, mezcladas con el texto a analizar. Separarlas aclara al modelo qué es norma y qué es dato, y deja un prefijo idéntico en todas las llamadas, que es lo que necesita la caché si algún día compensa activarla.
Una regla, un sitio. La lista de categorías aparecía dos veces: en el texto del prompt y en el enum del esquema. Si el esquema ya restringe los valores, repetirlos en el prompt solo añade tokens. Deja en el prompt únicamente lo que el esquema no puede expresar.
Ejemplos (few-shot) solo donde el modelo falla. Un par de ejemplos bien elegidos corrigen errores recurrentes mejor que un párrafo de instrucciones. Pero cada ejemplo se paga en cada llamada: añádelos para mejorar la calidad, no por costumbre.
ANTES (mensaje de usuario, en cada llamada)
Dado el siguiente texto: "..."
Devuélveme un array con las entidades...
Reglas: 1... 2... categorías: a, b, c, d... 3...

DESPUÉS
system: reglas fijas, una vez, sin repetir el enum
user:   [id] texto a analizar
4. Tipado: deja de parsear texto
Si tu código hace trim(), quita comillas y compara con 'null', estás pidiendo texto libre donde necesitas un dato. Eso es justo lo que hacía nuestra segunda llamada:
let resultText = textResponse.text.trim();
if (resultText.startsWith('"') && resultText.endsWith('"')) resultText = resultText.slice(1, -1);
if (resultText.toLowerCase() === 'null') return null;
Hay tres formas de pedir la salida, de peor a mejor para producción:
| Forma | Ventaja | Riesgo |
|---|---|---|
| Texto libre + "no añadas explicaciones" | Ninguna | Formatos inesperados, parseo frágil, reintentos |
| Tool con esquema JSON | Salida estructurada | Sin strict, el esquema es una sugerencia |
Tool con strict: true o structured outputs | La salida valida siempre contra el esquema | Exige additionalProperties: false y required |
El esquema también forma parte del prompt: un enum de categorías, un campo type: ["string", "null"] o un array con descripción guían al modelo mejor que una frase. Y ahorran mucho dinero de forma indirecta, porque cada respuesta mal formada provoca una llamada repetida.
const PICK_TOOL = {
  name: 'pick_ids',
  strict: true,
  input_schema: {
    type: 'object',
    additionalProperties: false,
    required: ['picks'],
    properties: {
      picks: { type: 'array', items: {
        type: 'object', additionalProperties: false,
        required: ['entity', 'id'],
        properties: { entity: { type: 'string' }, id: { type: ['string', 'null'] } },
      }},
    },
  },
};
5. El razonamiento que pagas y no ves
El cliente no necesitaba tener el "thinking" (el razonamiento del modelo) activado para esta tarea. Aquí nos llevamos la mayor sorpresa, porque un 31% del gasto era razonamiento que nadie había pedido.
Me explico: los modelos recientes piensan por defecto. En Claude Haiku 5.5, el thinking adaptativo viene activado con un nivel de esfuerzo medio aunque no lo pidas. Ese razonamiento se factura como output, y a precio de output. Y por defecto su texto ni siquiera te lo envía: lo que tú ves es un bloque vacío y la cuenta de tokens.
Nuestra llamada de desambiguación pedía un solo identificador, unos 20 tokens de respuesta. Pero el modelo razonaba unos 400 tokens antes de contestar. Pagábamos 20 veces más output del que realmente estábamos utilizando.
La llamada de extracción, en cambio, no tenía este problema: usaba una tool forzada (tool_choice: {type: 'tool'}), y en este modelo una llamada forzada empieza directamente por la tool, sin pensar antes.
Cómo controlarlo:
- Revisa
usage.output_tokensfrente a lo que realmente lees. Si hay mucha diferencia, hay razonamiento oculto. - Baja el esfuerzo:
output_config: { effort: 'low' }. El modelo piensa menos y puede saltarse el razonamiento en tareas simples. - Desactívalo donde no aporta, si el modelo lo permite (
thinking: { type: 'disabled' }), o fuerza la tool. - Ajusta
max_tokensa lo que esperas. El razonamiento cuenta dentro de ese límite.
¿Cuándo sí merece la pena dejarle pensar? Cuando la tarea tiene pasos, ambigüedad real o un coste alto por equivocarse. Elegir un identificador entre cinco candidatos bien descritos no es el caso. Otro caso sería si tienes que clasificar con reglas sutiles: aquí sí puede merecer la pena activar el razonamiento. Pero mide la calidad con y sin razonamiento antes de decidir.
6. Elegir modelo: el más barato no siempre sale más barato
Al elegir un modelo casi siempre pensamos "¿cuánto cuesta el millón de tokens?", pero eso no es lo relevante. Lo que deberías plantearte es "¿cuánto cuesta cada tarea completada bien?". Tres puntos a tener en cuenta:
- Reintentos y errores. Un modelo barato que falla un 10% de las veces, y te obliga a reintentar o revisar a mano, puede salir más caro que uno mejor.
- El tokenizer. Cada generación cuenta los tokens a su manera. El mismo texto puede ocupar alrededor de un 30% más en un modelo que en otro. Si presupuestaste con un modelo y migraste a otro, vuelve a contar con la API de conteo de tokens.
- El esfuerzo también es una palanca. Antes de montar una cascada de modelos ("el pequeño primero, si duda, el grande"), prueba el modelo bueno con esfuerzo bajo. Los modelos recientes con poco razonamiento rinden a menudo igual de bien que modelos previos con razonamiento alto, y un solo modelo es más fácil de mantener y de cachear.
En nuestro caso el modelo pequeño era el adecuado, porque solo teníamos que extraer y elegir entre candidatos, que son tareas acotadas. Lo que fallaba era la forma en la que se llamaba al modelo, no la elección de uno u otro.
7. Menos llamadas, más trabajo por llamada
La palanca individual más grande fue recortar el contexto: supuso el 52% del ahorro.
Manda lo que el modelo necesita para decidir, no todo lo que tienes
Para elegir un candidato, enviábamos el listado completo de opciones del catálogo externo: diez resultados con descripción larga, imágenes, URLs, licencias y puntuaciones, serializados con JSON.stringify(data, null, 2). Unos 3.500 tokens por consulta. Para decidir bastaban cinco candidatos con cuatro campos:
const trim = items => items.slice(0, 5).map(({ result: r }) => ({
  id: r['@id'],
  name: r.name,
  type: r['@type'],
  desc: (r.description || '').slice(0, 160),
}));

JSON.stringify(trim(items)); // sin indentar
Resultado: de unos 3.500 a unos 225 tokens por consulta. Ojo con la indentación: los espacios y saltos de línea también son tokens, y el modelo no los necesita.
Agrupa elementos en una sola petición
Esta es una de las claves para optimizar costes en llamadas API a modelos LLM. Hacíamos una llamada por reseña para extraer las entidades, y otra por cada entidad sin resolver. Con lo que cada llamada volvía a pagar las instrucciones y el esquema (unos 400 tokens fijos). Nuestra solución:
- Extracción: 20 reseñas por llamada, cada una con su
id, y un esquema que devuelve un array de resultados. El coste fijo por reseña pasa de unos 600 tokens a unos 65. - Desambiguación: todas las entidades pendientes de una reseña en una sola llamada, con un array de respuestas.
El límite del agrupamiento es la calidad: con lotes demasiado grandes el modelo empieza a mezclar o saltarse elementos. Entre 10 y 30 elementos cortos por llamada suele ir bien, pero valida con tus datos que cada id de entrada tenga su salida.
8. Batch: la mitad de precio a cambio de paciencia
La API de Message Batches de Anthropic procesa las mismas peticiones de forma asíncrona con un 50% de descuento (similar en OpenAI u otros proveedores). Normalmente termina en minutos, pero el compromiso de entrega puede llegar a un máximo de 24 horas.
| ¿Encaja batch? | Sí | No |
|---|---|---|
| Tipo de proceso | Periódico (cada hora, cada noche) | Interactivo, el usuario espera |
| Latencia aceptable | Minutos u horas | Segundos |
| Volumen | Decenas o miles de peticiones por tanda | Peticiones sueltas |
Nuestro pipeline encaja porque es periódico. Se diseña en dos fases, ya que la segunda depende de la primera:
- Batch de extracción.
- Consulta a la base de datos y al catálogo externo con lo extraído.
- Batch de desambiguación con lo que queda sin resolver.
const batch = await client.messages.batches.create({
  requests: groups.map((g, i) => ({ custom_id: `extract-${i}`, params: buildParams(g) })),
});
// sondear batches.retrieve(batch.id) hasta processing_status === 'ended'
for await (const r of await client.messages.batches.results(batch.id)) {
  if (r.result.type === 'succeeded') save(r.custom_id, r.result.message);
  else requeue(r.custom_id); // errored / expired
}
Tres reglas para no llevarse sustos:
- Los resultados llegan en cualquier orden. Usa siempre
custom_idcomo clave; no confíes en la posición de los elementos en la respuesta. - Gestiona
erroredyexpired. Una petición que no termina en 24 horas expira y hay que reencolarla. - Los parámetros son los mismos. Todo lo que hemos explicado en las secciones anteriores (tipado, razonamiento, agrupación) se aplica igual. El descuento del 50% por hacer peticiones en batches se suma a los ahorros que conseguimos optimizando las requests.
9. Caché: la optimización que te puede salir cara
La caché de prompts guarda el prefijo fijo de la petición (tools, system y todo lo que no cambia) y lo cobra a una décima parte del precio en las siguientes llamadas. Tiene tres condiciones:
- El prefijo debe ser idéntico byte a byte. Una fecha o un ID dentro del
systemla rompe. - Debe superar un mínimo de tokens, que depende del modelo (en nuestro caso, 512 tokens en Haiku 5.5). Por debajo no se puede cachear y, ¡ojo!, no avisa del error.
- Escribir cuesta más que leer: la primera vez se paga 1,25 veces el precio del input; las lecturas, 0,1 veces. Para que lo entendáis mejor: pagas un 25% más por la primera petición y te ahorras el 90% en las siguientes.
Nuestro prefijo ocupaba unos 350 tokens. La tentación es obvia: ¿y si lo relleno hasta 512 para que se cachee? Para no quedarnos con las dudas, hicimos la prueba. Y esto es lo que pasa con una tanda de test con 100 llamadas, contado en tokens equivalentes a precio de input:
| Escenario | Tokens equivalentes |
|---|---|
| Sin caché: 350 × 100 | 35.000 |
| Relleno a 512, llamadas escalonadas: 1 escritura + 99 lecturas | ~5.700 |
| Relleno a 512, 100 llamadas en paralelo | ~64.000 |
En paralelo sale casi el doble de caro. La caché solo está disponible cuando la primera petición ya ha empezado a responder: si las lanzas todas a la vez, todas fallan y todas pagan la escritura. Para aprovecharla correctamente hay que calentarla ("warming") primero con una petición y lanzar el resto después.
Y en nuestro caso, tras agrupar 20 reseñas por llamada, el prefijo se paga unas pocas veces por tanda. El ahorro posible se queda en céntimos al mes, por lo que no compensa "trucar" la request para poder activar el "prompt caching".
Resumiendo: la caché brilla con prefijos largos y repetidos (documentos, manuales, historiales de conversación), no con prompts cortos. Si añades tokens, que sean ejemplos que mejoren la calidad; si con eso pasas el mínimo, la caché va a ser un regalo que te hará ahorrar mucho dinero. Y comprueba siempre usage.cache_read_input_tokens: si se queda en cero, algo está invalidando el prefijo y rompiendo la caché.
10. Resultados: antes y después
El coste por cada 1.000 reseñas baja de $1,27 a $0,08: un 94% menos. Recortar el contexto y desactivar el razonamiento oculto suman el 83% del ahorro. Agrupar llamadas aporta poco ahorro directo, pero reduce las peticiones a un tercio.
| Por reseña | Input (tokens) | Output (tokens) | Llamadas por 1.000 reseñas |
|---|---|---|---|
| Antes | ~7.900 | ~960 | ~3.000 |
| Después | ~765 | ~150 | ~1.050 |
Supuesto: una media de dos entidades por reseña que hay que desambiguar. Con 100.000 reseñas al mes, la factura pasa de unos $127 a $15 en modo síncrono, o a unos $7,60 con batch.
11. Checklist de request engineering
Os dejo diez preguntas para auditar cualquier llamada que estéis diseñando, antes de llevarla a producción:
- ¿Están las instrucciones fijas en
systemy los datos en el mensaje de usuario? - ¿Aparece alguna regla dos veces (en el prompt y en el esquema)?
- ¿La salida es estructurada y estricta, o parseas texto libre?
- ¿Sabes si el modelo está razonando? ¿Comparas
output_tokenscon lo que realmente lees? - ¿El nivel de esfuerzo es el adecuado para la tarea, o el que viene por defecto?
- ¿Envías solo los campos que el modelo necesita para decidir? ¿Sin indentar?
- ¿Podrías procesar varios elementos en una sola llamada?
- ¿Alguien espera la respuesta en tiempo real? Si no, ¿por qué no usas batch?
- ¿Tu prefijo es lo bastante largo y estable para cachearlo? ¿Lanzas las llamadas en paralelo?
- ¿Mides
usagepor llamada y calculas el coste por tarea completada, no por petición?
El prompt importa, claro, pero es solo una parte de la petición. La factura real va a depender de todo lo demás. Así que mi consejo es que te olvides de tanto "prompt engineering", que es algo muy de posts "magufos" de LinkedIn de 2025: los modelos han evolucionado mucho en los últimos meses como para perder tanto tiempo en el prompting de usuario. Aprender "request engineering", "context engineering" o a configurar y optimizar un buen "harness" para tu agente te va a ser mucho más útil que cualquier guía de prompting barato que leas en internet.
12. Recursos oficiales para aprender "Request/Inference engineering" y diseñar correctamente las llamadas a las APIs de proveedores de IA
Anthropic: Optimizing for cost and intelligence
https://platform.claude.com/docs/en/about-claude/models/optimizing-for-cost-and-intelligence
Separa las palancas que ahorran sin perder calidad (prompt caching, recortar tokens de entrada, batch, revisar prompts antiguos) de las que intercambian calidad por coste (elección de modelo, effort, límites de output, estrategias multimodelo). También explica cómo medir el coste por tarea completada con tu propia carga de trabajo.
OpenAI: Cost optimization
https://developers.openai.com/api/docs/guides/cost-optimization
Cubre hacer menos peticiones, usar menos tokens y elegir modelos más pequeños. Incluye la Batch API y flex processing, un modo más barato con menor prioridad para peticiones que no corren prisa.